AI data governance es el conjunto de políticas, controles y procesos que permiten gestionar cómo los sistemas de inteligencia artificial acceden, utilizan y generan datos, garantizando su seguridad, trazabilidad y cumplimiento.
Durante años, la gobernanza del dato fue una de esas cosas que todo el mundo decía que había que hacer y casi nadie priorizaba. Documentación, comités, un catálogo que se actualizaba a mano y una auditoría anual. Era buena práctica. En 2026 ha dejado de serlo para convertirse en obligación legal, y el cambio no es de grado: los sistemas de IA de alto impacto tienen ahora requisitos explícitos de explicabilidad, linaje del dato, evaluación de sesgos y trazas de auditoría.
Ese giro deja al descubierto una debilidad conocida. La gobernanza tradicional se diseñó para asegurar que dos informes dieran la misma cifra; lo que se exige ahora es producir documentación continua y defendible de qué información alimentó cada decisión automatizada. Son objetivos distintos, y el segundo no se alcanza estirando el primero.
| Lo que este artículo intenta dejar claro
• El titular «la UE ha retrasado el AI Act» es medio cierto y peligrosamente impreciso: unas obligaciones se aplazaron y otras están aplicando ahora mismo. • Gobernar la IA no exige una gobernanza paralela: exige que la que ya tienes viva en el sitio correcto. • El agujero real no está en los modelos, sino en las identidades no humanas que acceden a tus datos. |
1. AI Act: el calendario que casi todo el mundo leyó mal
A finales de 2025 quedó claro que la implantación del EU AI Act iba con retraso: faltaban autoridades nacionales designadas y estándares armonizados. La Comisión Europea respondió con el Digital Omnibus on AI, propuesto el 19 de noviembre de 2025 y finalmente publicado como Reglamento (UE) 2026/1744 en el Diario Oficial el 24 de julio de 2026, en vigor desde el 27 de julio, apenas seis días antes de la fecha original que pretendía modificar.
La prensa lo resumió como «la UE retrasa el AI Act». Y ahí está el problema, porque el Omnibus no movió el calendario en bloque: movió unas cosas y dejó otras exactamente donde estaban.
Se aplazaron las obligaciones para sistemas de alto riesgo: los autónomos del Anexo III —contratación, scoring crediticio, educación, infraestructura crítica— pasan del 2 de agosto de 2026 al 2 de diciembre de 2027, y los embebidos en productos ya regulados del Anexo I, al 2 de agosto de 2028. Son fechas fijas: el mecanismo condicional de «seis o doce meses tras confirmarse los estándares» que se había barajado desapareció del texto final.
Lo que no se aplazó son las obligaciones de transparencia del Artículo 50, que entraron en aplicación el 2 de agosto de 2026 según el calendario original y por tanto ya están vigentes. La única excepción es estrecha: el requisito de marcado del Artículo 50(2) para los sistemas que ya estaban en el mercado en esa fecha recibió una prórroga de cuatro meses, hasta el 2 de diciembre de 2026, fecha en la que también empiezan a aplicar las nuevas prohibiciones que el Omnibus introdujo en el Artículo 5.
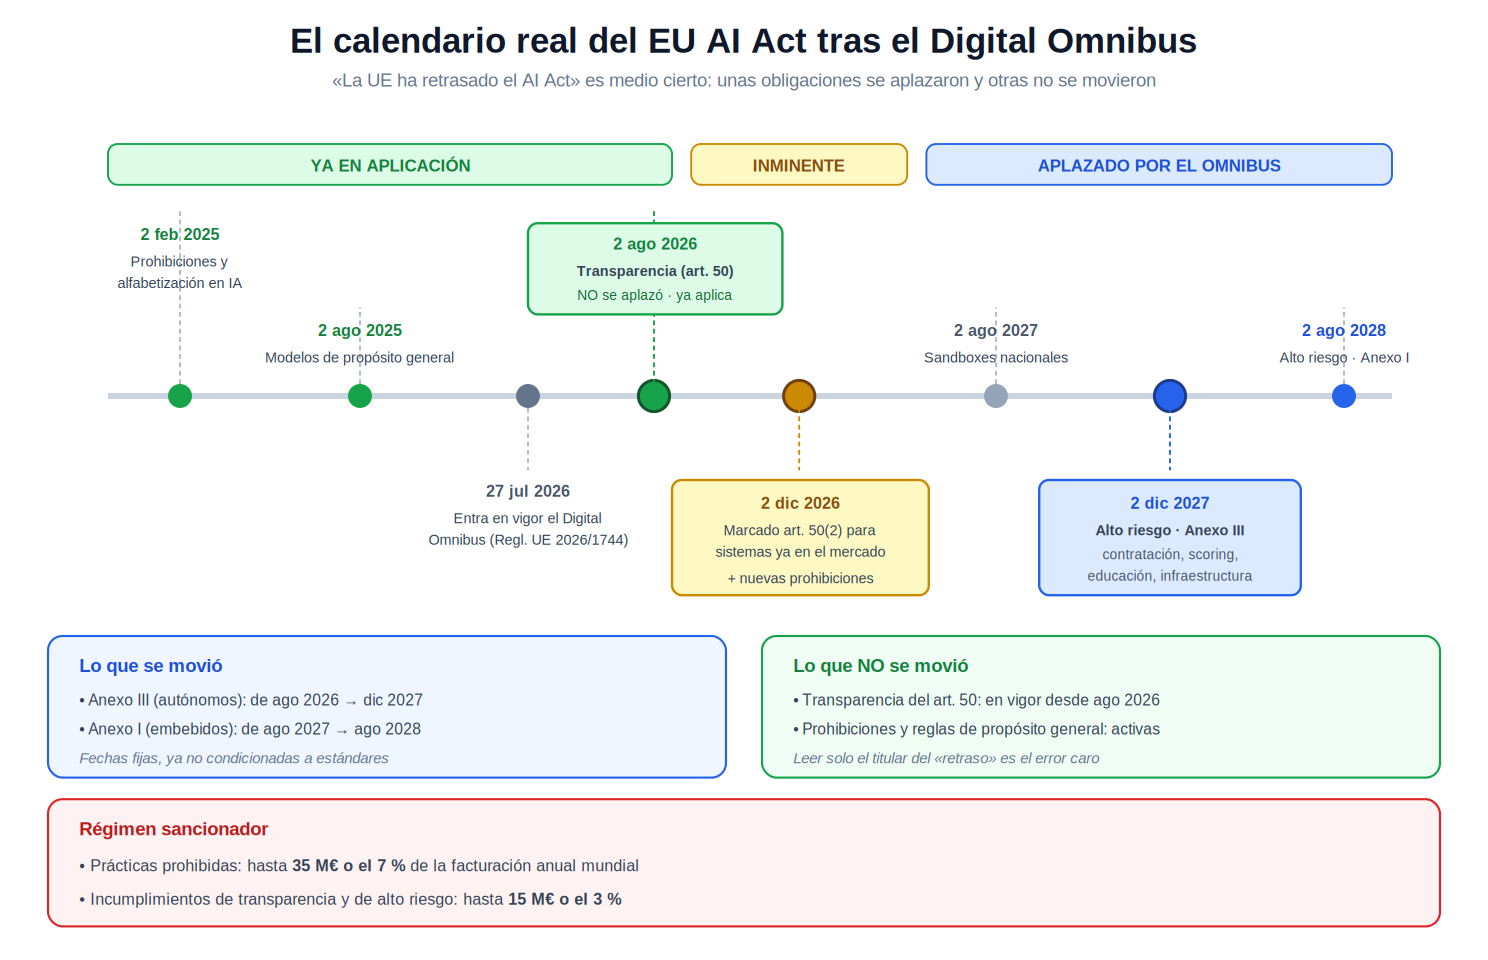
La magnitud del riesgo la marcan las sanciones: hasta 35 millones de euros o el 7 % de la facturación anual mundial para las prácticas prohibidas, y hasta 15 millones o el 3 % para los incumplimientos de transparencia y de alto riesgo. De todo esto se extrae una conclusión operativa incómoda: el principal riesgo de cumplimiento ahora mismo es trabajar con documentación desactualizada. Si tu calendario interno se construyó leye
2. ¿Qué cambia con AI data governance?
Más allá del calendario, conviene entender por qué la IA rompe el modelo clásico. Hay tres desplazamientos.
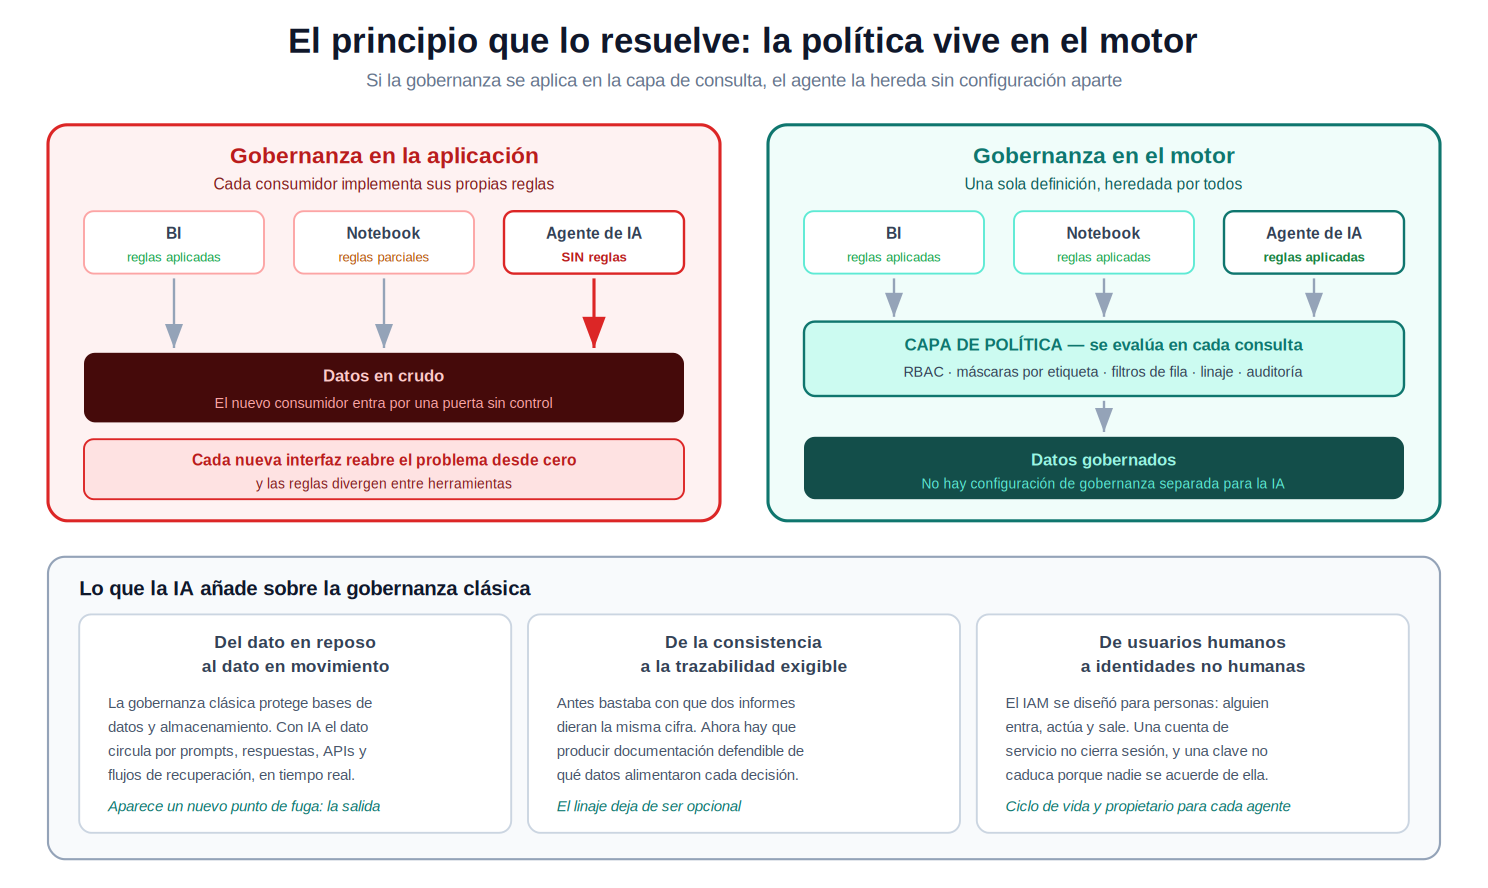
El primero va del dato en reposo al dato en movimiento. La gobernanza tradicional protege bases de datos, almacenamiento y controles de acceso. Con sistemas de IA, la información circula por prompts, respuestas, APIs y flujos de recuperación en tiempo real, y puede aparecer dentro de una consulta de usuario o de un documento contextual. Aparece un punto de fuga que antes no existía: la salida. De ahí que las plataformas hayan empezado a incorporar detección y redacción de información personal en las respuestas de los agentes, no solo en las tablas.
El segundo va de la consistencia a la trazabilidad exigible. Ya no basta con que dos departamentos vean la misma cifra; hay que poder reconstruir, ante un auditor, qué datos se usaron para producir una decisión concreta. El linaje deja de ser una funcionalidad agradable del catálogo y pasa a ser el soporte probatorio de tu cumplimiento.
Y el tercero va de usuarios humanos a identidades no humanas, que es la parte que más equipos están subestimando y que merece su propia sección.
3. Cómo implementar AI data governance en el motor de datos
Aquí está la buena noticia para un equipo de datos, y es más grande de lo que parece. Si las políticas de gobernanza se ejecutan en la capa del motor de consulta y no en la capa de aplicación, se aplican automáticamente a cualquiera que pregunte: un analista humano, una herramienta de BI o un agente de IA. Dicho de otro modo, no hace falta una configuración de gobernanza separada para las cargas de trabajo de IA.
Ese principio convierte un problema que suena nuevo en uno que ya sabes resolver. Si el enmascaramiento, los filtros de fila y el control de accesos viven en el warehouse, el agente los hereda por construcción. Si viven en la capa de presentación de cada herramienta, cada nuevo consumidor reabre el problema desde cero, y el agente entra por una puerta que nadie vigiló.
En un stack Snowflake, esto se traduce en un patrón muy concreto: clasificar con etiquetas y colgar la política de la etiqueta, no de la columna. Así, cuando aparezca una tabla nueva con datos sensibles, basta etiquetarla para que quede protegida.
| — 1) Una taxonomia de sensibilidad, no una politica por columna
CREATE TAG governance.sensibilidad ALLOWED_VALUES ‘publico’, ‘interno’, ‘confidencial’, ‘pii’;
— 2) La politica de enmascaramiento se define UNA vez CREATE MASKING POLICY governance.mask_pii AS (val STRING) RETURNS STRING -> CASE WHEN IS_ROLE_IN_SESSION(‘ROL_DATOS_SENSIBLES’) THEN val ELSE ‘***REDACTADO***’ END;
— 3) Se asocia a la ETIQUETA, no a cada columna ALTER TAG governance.sensibilidad SET MASKING POLICY governance.mask_pii;
— 4) Etiquetar una columna basta para protegerla ALTER TABLE analytics.clientes MODIFY COLUMN email SET TAG governance.sensibilidad = ‘pii’; |
A partir de ahí, cualquier consulta contra analytics.clientes —venga de un dashboard, de un notebook o de un agente— devuelve el correo enmascarado salvo que el rol tenga permiso explícito. La misma lógica se extiende a las vistas semánticas: heredan las políticas de enmascaramiento y de acceso por fila de las tablas subyacentes, de modo que una interfaz conversacional sobre ellas queda gobernada sin trabajo adicional. Es exactamente el patrón que describíamos al hablar de analítica conversacional, visto ahora desde el lado del cumplimiento.
4. Identidades no humanas: el reto de gobernar los agentes de IA
Si hay una parte de este tema que está claramente por detrás del resto, es esta. La gestión de identidades se diseñó para personas: alguien entra, hace algo y sale, y una sesión caduca sola aunque nadie se acuerde de revocarla. Nada de eso aplica a una cuenta de servicio, una clave de API o el token que empuña un agente. Una cuenta de servicio no cierra sesión. Una clave no caduca porque alguien la olvide durante un puente. Sigue siendo válida indefinidamente hasta que alguien la revoque de forma activa, y en la mayoría de organizaciones nadie tiene asignada esa tarea.
Las cifras sobre cuántas identidades no humanas hay por cada humana varían muchísimo según la metodología —se citan proporciones que van de 25 a 1 hasta más de 100 a 1— así que conviene no aferrarse a ninguna en particular. Lo relevante es que todos los estudios coinciden en la dirección y en la velocidad: la investigación de KPMG sitúa el recuento de identidades máquina en unas 250.000 en la empresa media, frente a unas 50.000 en 2021.
Pero el dato que de verdad debería preocupar a un responsable de datos no es la proporción, sino este: solo alrededor de la mitad de las organizaciones puede rastrear y auditar a qué datos acceden sus agentes de IA. La otra mitad tiene un punto ciego completo justo donde la nueva regulación exige trazabilidad. Y hay un hueco declarativo parecido: la inmensa mayoría de los directivos considera crítico gobernar los agentes, mientras que menos de la mitad ha implantado alguna política para hacerlo.
Esto conecta directamente con el protocolo del que hablábamos en el primer artículo de esta serie. En un estudio sobre cerca de ocho mil servidores MCP accesibles, alrededor del 40 % no tenía ningún tipo de autenticación. Un servidor MCP mal configurado es, en la práctica, una puerta abierta a datos gobernados. La conclusión práctica: cada agente necesita un propietario con nombre, un ciclo de vida y una fecha de caducidad, igual que cualquier empleado. Un agente que nadie ha revisado en un año es exactamente el mismo riesgo que un exempleado con las credenciales aún activas.
5. Los marcos para AI governance: cuál elegir y para qué
Para estructurar el trabajo hay dos referencias que conviene no confundir, porque resuelven necesidades distintas.
- NIST AI RMF es un marco voluntario y gratuito de gestión de riesgos, flexible y adaptable. No requiere relación con ninguna entidad auditora y funciona muy bien como taxonomía interna y disciplina de ciclo de vida. Es el camino hacia una autodeclaración.
- ISO/IEC 42001 es la primera norma internacional de sistema de gestión de IA y, a diferencia de la anterior, es certificable por un tercero. Es el camino hacia un certificado, y por tanto la que sirve cuando el interlocutor es un cliente, un departamento de compras o un regulador que pide garantías externas.
El orden que recomiendan quienes han hecho ambas cosas es pragmático: empezar por NIST para establecer el vocabulario y la disciplina, y superponer después la certificación ISO 42001 cuando la documentación ya esté hecha. Y hay un atajo que merece la pena conocer: si tu organización ya está certificada en ISO 27001, la estructura armonizada de las normas ISO hace que el salto a la 42001 sea bastante menor que partir de cero. Conviene además saber que la certificación está pasando de ser un diferenciador a ser un requisito de entrada en procesos de compra de ciertos sectores.
6. Cómo empezar una estrategia de AI data governance
Un orden de trabajo que evita el error más común, que es montar un comité antes de tener un inventario:
- Inventaría primero, escribe políticas después. Qué sistemas de IA hay en uso, quién los usa, a qué datos acceden y con qué credenciales. Sin esto, cualquier política es teoría.
- Clasifica el dato con etiquetas y cuelga las políticas de las etiquetas, como en el ejemplo anterior. Es lo que hace que la gobernanza escale sin añadir personas.
- Baja las políticas al motor. Si alguna regla solo existe dentro de una herramienta de BI, tienes una fuga esperando a que alguien conecte un agente.
- Dale a cada agente identidad propia, propietario y caducidad. Nunca credenciales compartidas o heredadas: sin identidad distinta no hay auditoría posible.
- Comprueba que puedes responder «¿qué datos consultó este agente el martes?». Si la respuesta es que no lo sabes, ese es tu primer proyecto, por delante de cualquier marco.
- Revisa tu calendario regulatorio contra el texto vigente, no contra titulares. Y anota el 2 de diciembre de 2026, que está a la vuelta de la esquina.
Conclusión
La gobernanza de datos para IA suena a disciplina nueva y en buena medida no lo es. Las piezas fundamentales —clasificar, enmascarar, controlar accesos, registrar linaje, auditar— son las mismas que un buen equipo de datos lleva años construyendo. Lo que cambia es dónde tienen que vivir esas piezas para seguir funcionando cuando el que consulta es una máquina, y el nivel de prueba documental que ahora exige la ley.
Si tuviera que quedarme con dos ideas, serían estas. La primera: baja las políticas al motor, porque es lo que convierte «gobernar la IA» en algo que se resuelve una vez en lugar de una vez por herramienta. La segunda: trata a cada agente como tratas a un empleado, con identidad propia, permisos mínimos, un responsable y una fecha de revisión. El resto —los marcos, los comités, la documentación— es mucho más fácil de construir cuando esas dos cosas ya están en su sitio.
Nota: este artículo no constituye asesoramiento jurídico. El calendario regulatorio descrito corresponde a la situación tras la entrada en vigor del Reglamento (UE) 2026/1744 y puede evolucionar; verifica siempre las fechas y obligaciones aplicables a tu caso con el texto oficial y con asesoría legal. Las proporciones de identidades no humanas proceden de estudios con metodologías distintas y no son directamente comparables entre sí. Las funcionalidades de gobernanza citadas requieren, en Snowflake, edición Enterprise o superior.
Preguntas frecuentes de AI data governance
¿Qué es AI data governance?
AI data governance es el conjunto de políticas, controles y procesos utilizados para gestionar los datos que emplean los sistemas de inteligencia artificial, garantizando su acceso adecuado, trazabilidad, seguridad y cumplimiento.
¿Por qué es importante AI data governance?
AI data governance permite controlar qué datos utilizan los sistemas y agentes de IA, quién puede acceder a ellos y cómo se puede demostrar su uso. Esto resulta especialmente relevante cuando las organizaciones necesitan garantizar trazabilidad y cumplimiento normativo.
¿Qué relación existe entre AI data governance y el EU AI Act?
El EU AI Act establece obligaciones para determinados sistemas de IA relacionadas, entre otros aspectos, con transparencia, documentación, trazabilidad y gestión de riesgos. Una estrategia de AI data governance ayuda a las organizaciones a controlar y documentar los datos utilizados por estos sistemas.
¿Cuál es la diferencia entre AI governance y AI data governance?
AI governance aborda la gestión global de los sistemas de inteligencia artificial, incluyendo riesgos, responsabilidades, políticas y cumplimiento. AI data governance se centra específicamente en los datos utilizados por estos sistemas: acceso, clasificación, protección, trazabilidad y uso.
¿Cómo implementar AI data governance?
El proceso puede comenzar con un inventario de los sistemas de IA y de los datos a los que acceden, seguido de la clasificación de los datos, la aplicación de políticas de acceso y protección en el motor de datos y la asignación de una identidad, propietario y ciclo de vida a cada agente de IA.
¿Qué frameworks existen para AI data governance?
NIST AI RMF e ISO/IEC 42001 son dos referencias relevantes, aunque tienen objetivos diferentes. NIST AI RMF proporciona un marco voluntario para gestionar riesgos de IA, mientras que ISO/IEC 42001 establece los requisitos de un sistema de gestión de IA certificable.