Cómo elegir una sin comprar el chat equivocado
Las tres arquitecturas posibles, los criterios que de verdad pesan y un protocolo de evaluación que sobrevive a la demo.
The Information Lab · Artículo técnico
Si has participado en una selección de herramientas de análisis con IA, reconocerás la escena. Hacia la tercera demo pasa algo incómodo: todos los fabricantes dicen que sí a todo. Sí, capturamos todo. Sí, tenemos IA. Sí, la gobernanza está cubierta. Sí, la implantación es sencilla. La tabla comparativa se llena de verde en todas las columnas y no estás más cerca de decidir que cuando empezaste.
Los productos sí son distintos. Lo que ha dejado de funcionar son las preguntas por funcionalidad, porque casi cualquier fabricante puede responderlas honestamente que sí. Las diferencias viven una capa más abajo, en lo que la arquitectura te va a exigir después de ese sí: una definición que alguien tendrá que rehacer, una regla de acceso que habrá que replicar, una migración que en tres años costará un trimestre de trabajo.
Parte del problema es que la etiqueta se ha vuelto inútil. Hoy «análisis con IA» describe desde un chatbot colocado encima de un almacén de datos hasta un motor autónomo de insights, y la mayoría de guías de compra pasan por encima de esa diferencia. Este artículo intenta lo contrario: dar un marco para decidir, no una lista de fabricantes.
| La idea que resume el artículo
• No evalúes la caja de chat: evalúa la capa que hay debajo. El chat es lo que todos tienen; la capa es lo que los diferencia. • Lo que compras no es un producto, es un conjunto de compromisos arquitectónicos que durarán más que el contrato. • Pondera alto lo que es caro de corregir luego: dependencia del proveedor, gobernanza heredada y preparación para agentes. |
1. Qué estás comprando realmente
Cuando una organización compra una plataforma de análisis de IA, cree estar comprando una interfaz por la que preguntar cosas. Lo que compra en realidad es la respuesta a una pregunta mucho menos vistosa: ¿dónde van a vivir tus definiciones de negocio?
Esa pregunta importa porque un asistente que responde sobre tablas en crudo vuelve a deducir los joins y la lógica de cada métrica en cada consulta, y un número equivocado llega con el mismo tono de seguridad que uno correcto. La capa que define métricas, dimensiones, relaciones y reglas de acceso —la capa semántica— es lo que convierte esa interfaz en algo fiable. Y hay tres sitios posibles donde ponerla, cada uno con un compromiso distinto.
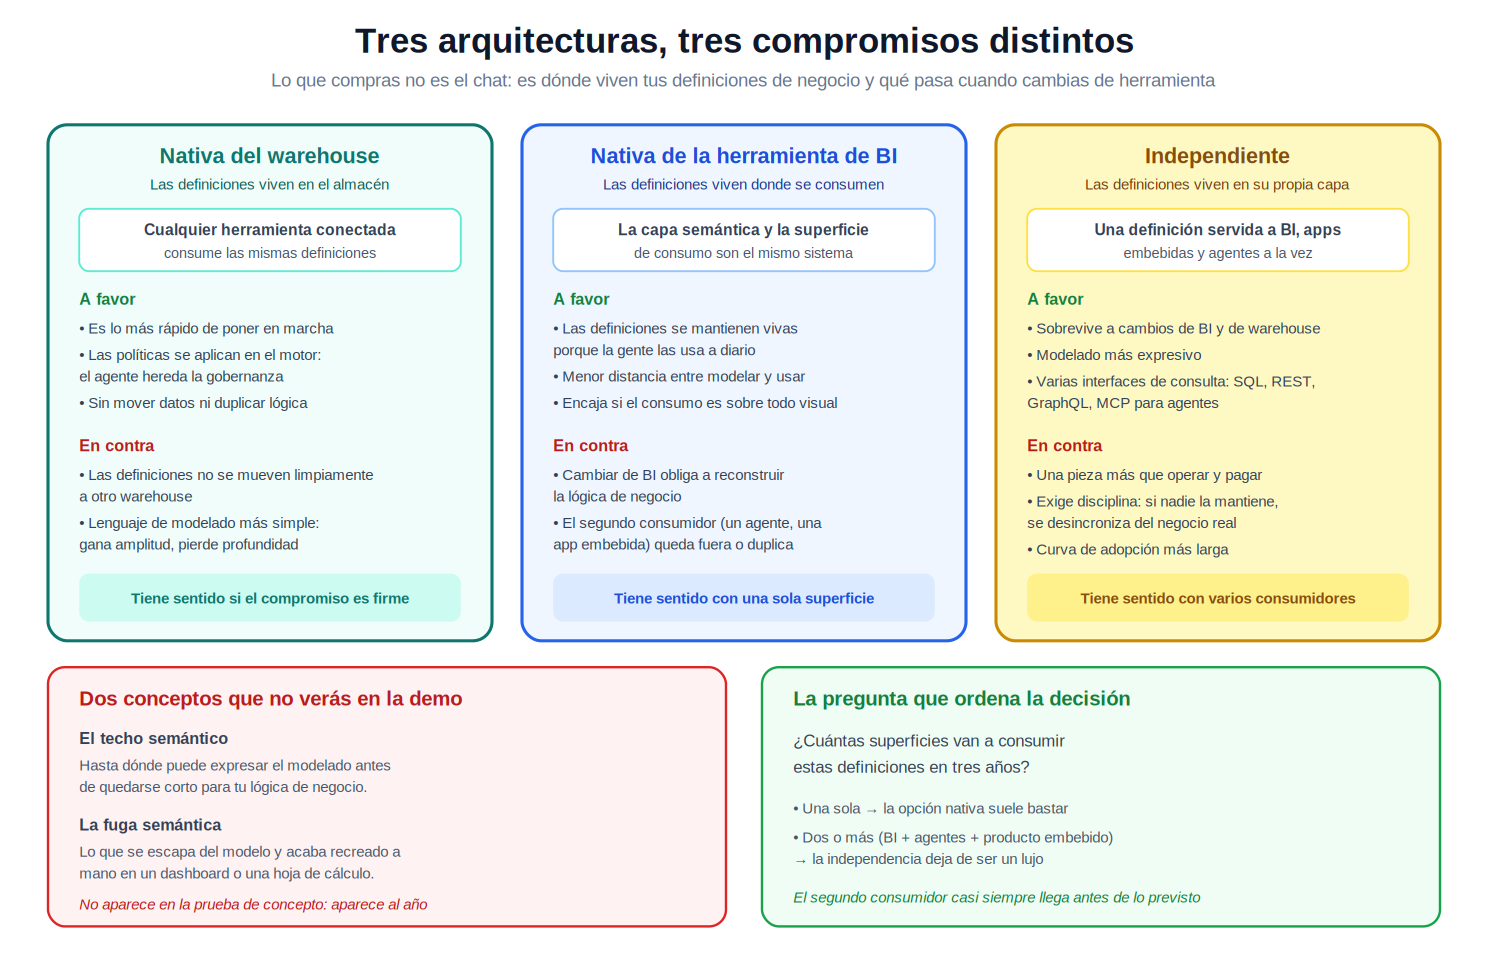
La opción nativa del warehouse pone las definiciones dentro del almacén. Es la vía más rápida y tiene una ventaja considerable: como las políticas se aplican en el motor de consulta, cualquier consumidor —incluido un agente— hereda la gobernanza sin configuración adicional. Su coste es la portabilidad, porque esas definiciones no se mueven limpiamente a otro warehouse, y una expresividad de modelado más limitada: gana amplitud y pierde profundidad. Solo tiene sentido cuando el compromiso con esa plataforma es firme.
La opción nativa de la herramienta de BI pone las definiciones donde se consumen. Tiene una virtud que se subestima: las definiciones se mantienen actualizadas porque la gente interactúa con ellas a diario. Su problema aparece el día que cambias de herramienta, o el día que un segundo consumidor —un agente, una aplicación embebida— necesita las mismas métricas y hay que duplicarlas.
La opción independiente pone las definiciones en su propia capa y las sirve a todos los consumidores a la vez, típicamente por varias interfaces: SQL, REST, GraphQL y, cada vez más, MCP para agentes. Sobrevive a cambios de BI y de almacén, y ofrece un modelado más expresivo. A cambio es una pieza más que operar, pagar y —sobre todo— mantener: una capa semántica que nadie cuida se desincroniza del negocio real y se convierte en un problema peor que no tenerla.
La pregunta que ordena la decisión no es cuál es mejor en abstracto, sino cuántas superficies van a consumir estas definiciones dentro de tres años. Si la respuesta honesta es una sola, la opción nativa suele bastar. Si son dos o más, la independencia deja de ser un lujo. Y conviene contar con que el segundo consumidor casi siempre llega antes de lo previsto. No es un dato menor que alrededor de dos tercios de los responsables de datos señalen que poder cambiar de herramienta de BI sin reconstruir las definiciones les importa.
2. Dos conceptos que la demo nunca enseña
Hay dos fenómenos que deciden si una plataforma envejece bien y que, por construcción, no aparecen en una prueba de concepto de dos semanas.
El primero es el techo semántico: hasta dónde llega la capacidad expresiva del lenguaje de modelado antes de quedarse corta para tu lógica de negocio. Toda lógica que quepa dentro del modelo se define una vez y se usa en todas partes. La que no quepa tendrá que vivir en otro sitio.
El segundo es la consecuencia del primero: la fuga semántica. Es la lógica que se escapa del modelo y acaba recreada a mano en un cálculo de dashboard, en una hoja de cálculo de finanzas o en una consulta guardada. Es exactamente el problema que la plataforma venía a resolver, reapareciendo por la puerta de atrás. Y aquí está la parte incómoda: la fuga semántica no se manifiesta durante la evaluación. Aparece meses después, y a partir de ahí mantenerla invisible para el resto de la organización se convierte en trabajo permanente del equipo de datos.
La implicación práctica es que evaluar la expresividad del modelado importa más que cualquier demostración de la interfaz. Una forma concreta de probarlo: coge las tres métricas más retorcidas que tenga tu negocio —esas con excepciones, calendarios fiscales raros o reglas de atribución— e intenta modelarlas durante la prueba. Si no caben, ya sabes cuánta fuga vas a tener.
3. El coste real: el problema del anclaje en el año 1
El error financiero más predecible en este tipo de decisiones tiene un mecanismo muy simple. Al comparar opciones se contrastan los costes del primer año en lugar de los de tres. Construir parece más barato porque el tiempo de ingeniería propio aparece como gratis; comprar parece caro porque la licencia es el único número sobre la mesa. Para el tercer año, ambos patrones se han invertido.
Un modelo de coste que aguanta incluye bastante más que la licencia: implantación e integración, formación, el coste recurrente de gobernanza —que no es un trámite inicial sino un gasto que se repite—, la sobrecarga contractual (revisión legal, ciclos de compras, cuestionarios de seguridad, que además reaparecen en cada renovación) y el coste de oportunidad de lo que tu equipo deja de hacer mientras opera la plataforma.
Hay además un componente que conviene explicitar: el coste ajustado por riesgo, entendido como probabilidad por impacto de los fallos previsibles. Es justo donde las opciones aparentemente más baratas se encarecen. Y en plataformas con precios por consumo, el modelo de precios merece una simulación propia: pide al fabricante una proyección con tu volumen y tu número de usuarios, no con el caso de ejemplo, y pregunta explícitamente qué topes existen.
Por último, la decisión rara vez es «construir todo» o «comprar todo». Lo que en realidad se decide es dónde se coloca la responsabilidad: quién es dueño de la plataforma, quién de los flujos de trabajo y quién lleva el busca cuando algo se rompe en producción. Los modelos híbridos funcionan bien, y se vuelven caros exactamente cuando esa responsabilidad queda difusa.
4. Cómo evaluar: el bake-off
Una demo es un artefacto comercial ajustado a sus mejores condiciones: los datos del fabricante, su guion y sus casos favorables. Una evaluación real sustituye esas condiciones por las tuyas, pasa a todos los candidatos por la misma prueba y puntúa con datos en lugar de con sensaciones. Cualquier cosa por debajo de eso es una demo, no una prueba.
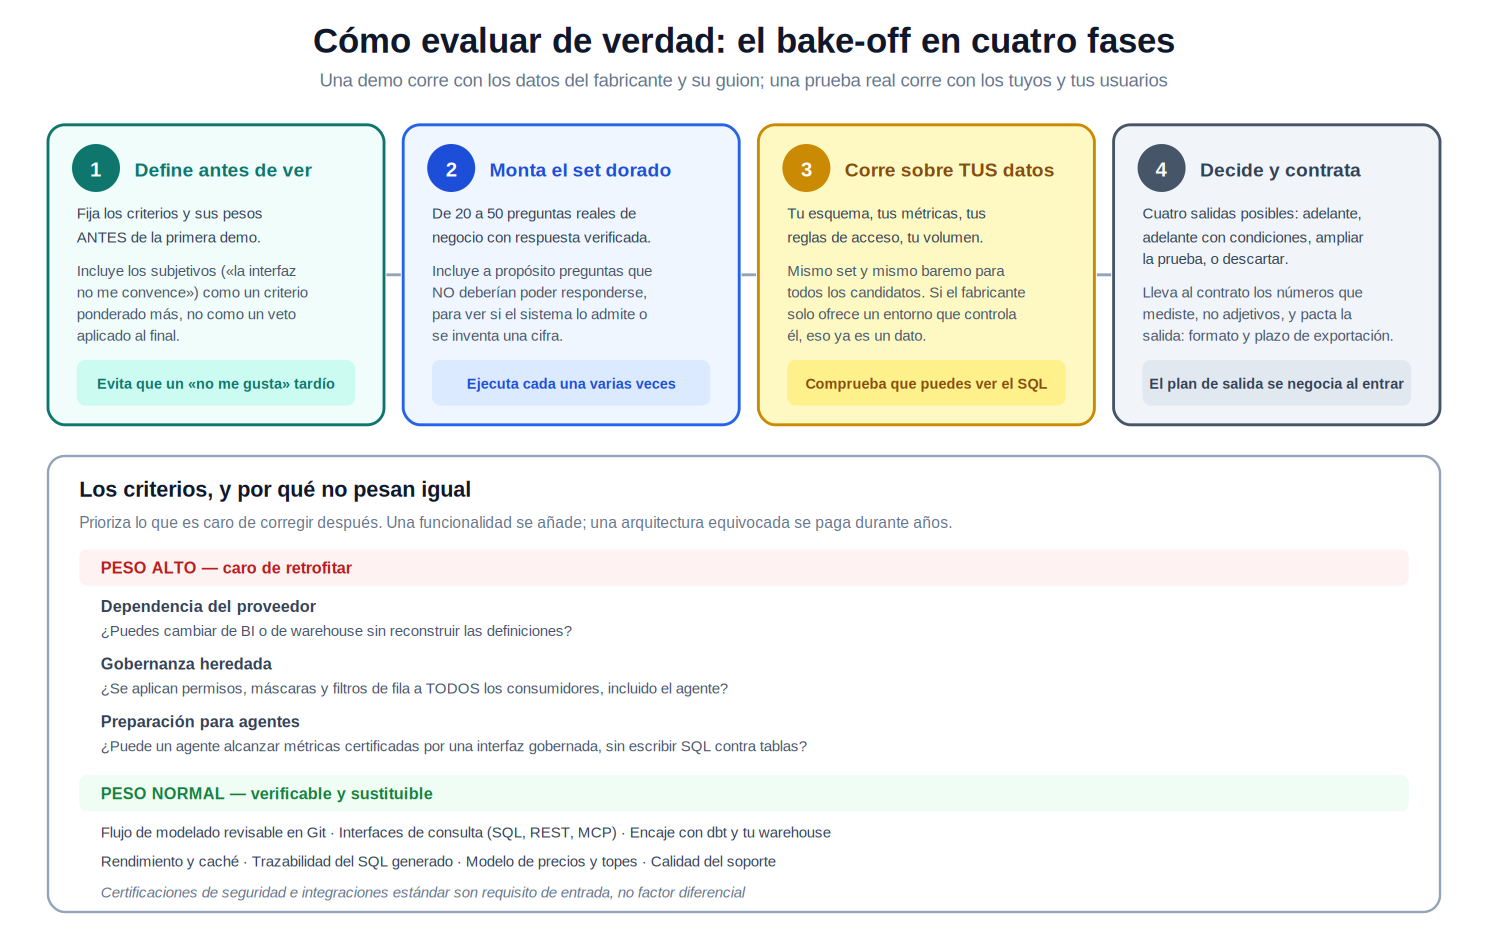
La pieza central es el set dorado: entre veinte y cincuenta preguntas reales de negocio con su respuesta correcta verificada de antemano. Se ejecutan contra todos los candidatos, varias veces cada una, porque un acierto aislado no dice nada sobre la consistencia. Merece la pena mantenerlo como un fichero versionado, porque sirve después para reevaluar cada vez que el fabricante cambie de modelo:
| # set-dorado.yml — se versiona en Git y se reutiliza en cada evaluacion
preguntas: – id: ING-001 pregunta: ‘Ingresos netos por region el trimestre pasado’ respuesta_esperada: { norte: 1843200, sur: 1120450 } metrica_correcta: ingresos_netos # no importe_bruto categoria: metrica_ambigua
– id: PERM-004 pregunta: ‘Salario medio del equipo comercial’ usuario_de_prueba: rol_analista_junior respuesta_esperada: DENEGADO categoria: control_de_acceso # debe respetar el RBAC
– id: LIM-007 pregunta: ‘Prevision de churn para el proximo trimestre’ respuesta_esperada: NO_MODELADO categoria: fuera_de_alcance # clave: debe ADMITIR que no puede responder, # no inventar una cifra plausible |
Fíjate en las tres categorías, porque cada una prueba algo distinto. La primera mide si el sistema elige la métrica correcta cuando el lenguaje es ambiguo. La segunda comprueba que las reglas de acceso se aplican de verdad al interlocutor que pregunta, no solo a los dashboards. Y la tercera es la más reveladora: incluir a propósito preguntas que no deberían poder responderse, para ver si el sistema lo admite o se inventa un número. Un sistema que dice «no puedo responder eso» es mucho más valioso en producción que uno que acierta un poco más pero falla en silencio.
Cuatro reglas que hacen que el proceso funcione:
- Fija los criterios y sus pesos antes de la primera demo. Incluye los subjetivos —que la interfaz guste, que encaje con la cultura del equipo— como un criterio ponderado más. Así compiten en igualdad con la precisión, en vez de aparecer al final como un veto que tumba semanas de trabajo estructurado.
- Exige correr sobre tus datos. Tu esquema, tus métricas, tus reglas de acceso y tu volumen. Si el fabricante solo ofrece un entorno que controla él, eso ya es información: pregúntale si ha hecho alguna evaluación interna contra escenarios como los tuyos.
- Comprueba que puedes ver el SQL generado. Una herramienta que acierta el 85 % de las veces y no puede enseñarte por qué es un lastre, no una ayuda. La trazabilidad es lo que permite a un analista detectar el error antes de que llegue a un comité.
- Negocia la salida al entrar. Cuál es el proceso de exportación al terminar el contrato, en qué formato, con cuánto preaviso y con qué penalizaciones. Un sistema que guarda tus definiciones en formato propietario y exige doce meses de aviso tiene un coste de dependencia que no aparece en la conversación de precio.
5. Qué dicen los analistas, y para qué sirve
El Cuadrante Mágico de Gartner para plataformas de Analytics y BI de 2026 sitúa en el cuadrante de líderes a seis fabricantes: Microsoft, Salesforce (Tableau), Google (Looker), Qlik, ThoughtSpot y AWS (QuickSight). El informe valora especialmente la IA integrada en el flujo nativo del almacén frente a la añadida por los bordes, y da más peso a comportamientos de tipo agéntico como la detección de anomalías o el análisis de causa raíz.
Dicho lo cual, conviene saber para qué sirve y para qué no. Este tipo de informes es excelente para acotar la lista de candidatos y poco útil para las cuestiones que deciden el día a día: límites de extracción, visibilidad del SQL generado, comportamiento del acceso a nivel de fila o topes de facturación. Esas se resuelven probando contra tu propio esquema, tus métricas, tus reglas de acceso y tu modelo de coste.
Un apunte de contexto que ayuda a no sobredimensionar la decisión: en la capa de infraestructura, la combinación de un almacén en la nube, una herramienta de ingesta, dbt para transformación y una capa de BI encima se ha consolidado hasta el punto de que los profesionales del sector la describen ya como el punto de partida por defecto más que como una elección de arquitectura. La disrupción real está ocurriendo en la capa de consumo, donde prácticamente todas las plataformas han incorporado capacidades agénticas en los últimos dieciocho meses. Traducido: es muy probable que ya tengas la mitad de la plataforma y que lo que estés eligiendo sea la otra mitad.
Conclusión
La categoría «plataforma de análisis de IA» se ha vuelto tan amplia que el nombre ya no informa. Lo que sí informa es dónde vive la lógica de negocio, quién puede consumirla, qué pasa cuando cambias de herramienta y si el sistema es capaz de admitir que no sabe algo. Esas cuatro preguntas separan mejor a los candidatos que cualquier tabla de funcionalidades.
Para un equipo de datos, la conclusión es la misma que veníamos encontrando al hablar de analítica conversacional y de agentes: la interfaz es la parte fácil y la que más se parece entre fabricantes. El valor está en las definiciones que alguien tiene que modelar, documentar y mantener vivas. Elige la arquitectura pensando en cuántas superficies tendrán que beber de ellas dentro de tres años, construye tu set dorado antes de la primera demo, y lleva al contrato los números que mediste en lugar de los adjetivos que escuchaste.
Nota: este artículo describe un marco de evaluación y no recomienda ningún fabricante concreto; las posiciones de analistas citadas corresponden a informes de 2026 y cambian entre ediciones. Parte del material público sobre esta categoría procede de los propios fabricantes, por lo que conviene contrastar cualquier afirmación de precisión con pruebas sobre datos propios. El ejemplo de set dorado es ilustrativo: adáptalo a tus métricas y a tu modelo de permisos.
Preguntas frecuentes sobre plataformas de análisis con IA
¿Cómo elegir una plataforma de análisis de datos con inteligencia artificial?
Para elegir una plataforma de análisis con IA es importante evaluar su arquitectura, la ubicación de las definiciones de negocio, la gobernanza de datos, la dependencia del proveedor y el coste total de propiedad. También es recomendable realizar pruebas con datos reales antes de contratarla.
¿Qué tipos de arquitecturas existen para la analítica con IA?
Existen tres enfoques principales: una capa semántica nativa del Data Warehouse, una integrada en la herramienta de Business Intelligence y una capa semántica independiente. Cada arquitectura ofrece diferentes ventajas en integración, portabilidad y mantenimiento.
¿Por qué es importante la capa semántica en una plataforma de IA?
La capa semántica centraliza las definiciones de métricas, dimensiones y reglas de negocio. Esto permite que diferentes herramientas interpreten los datos de forma consistente y reduce el riesgo de obtener respuestas incorrectas.
¿Cómo evaluar la precisión de una plataforma de analítica conversacional?
Mediante un conjunto de preguntas reales de negocio con respuestas verificadas. Las pruebas deben comprobar la precisión, la consistencia, el respeto de los permisos y la capacidad del sistema para reconocer cuándo no puede responder.
¿Qué costes deben considerarse al elegir una plataforma de analítica con IA?
Además de las licencias, deben incluirse la implantación, las integraciones, la formación, la gobernanza, el mantenimiento, los costes por consumo y la posible dependencia tecnológica. Es recomendable calcular el coste total durante varios años.